- Veröffentlicht am
Der Transformer wird zu einer Komponente.
- Autoren

- Name
- AbnAsia.org
- @steven_n_t
Listen in English · Der Transformer wird zu einer Komponente.
0:00 / 0:00
Watch in English · Der Transformer wird zu einer Komponente.
Verbringt man Zeit mit den Menschen, die Frontier-Modelle bauen, zeigt sich ein Muster, das die Ranglisten verbergen: Eine ungewöhnlich große Zahl von ihnen arbeitet an etwas, das kein Transformer ist.
Wenn man Zeit mit den Menschen verbringt, die Frontier-Modelle bauen, zeigt sich ein Muster, das die Ranglisten verbergen: Eine ungewöhnlich große Zahl von ihnen arbeitet an etwas, das kein Transformer ist.
In diesem Quartal wird es nicht ersetzt. Daran wird parallel mit echtem Geld als aktive Forschungsfrage gearbeitet. Prädiktive Architekturen im JEPA-Stil, die niemals ein Token oder ein Pixel generieren. Diffusions-Sprachmodelle, die einen ganzen Absatz auf einmal entrauschen. Mamba und die State-Space-Familie, die den quadratischen Scan von Attention durch einen rekurrenten Zustand fester Größe ersetzen. Jede ist eine andere Antwort auf dieselbe Frage: Was sollte die Maschine tatsächlich berechnen?
Was tatsächlich ausgeliefert wurde
Niemand hat ein rein rekurrentes Modell oberhalb der mittleren Größe veröffentlicht. Veröffentlicht wurde ein Verhältnis. Eine Vergleichsstudie zu hybrider linearer Attention verortete das nützliche Band bei 3:1 bis 6:1 von linear zu Full Attention, wobei Hybride auf Recall-Benchmarks an eine Full-Attention-Baseline heranreichen oder sie übertreffen – bei vier- bis siebenmal weniger KV-Cache. Der Bericht zu Kimi K3 setzt seine eigene Ablation bei 3:1 an – 5,65 Validierungs-Perplexität gegenüber 5,66 bei 1:1 – über 93 Textschichten, von denen 24 Full Attention verwenden. NVIDIA Nemotron-H berichtet von bis zu etwa dreimal schnellerer Inferenz bei gleicher Genauigkeit; IBM Granite 4.0-H berichtet von mehr als 70 Prozent geringerem Speicherbedarf.
Die State-Space-Debatte läuft seit Mamba im Jahr 2023. Die ehrliche Bilanz: Lineares Mischen in Linearzeit gewann Durchsatz und Speicher, verlor für sich genommen aber Recall, und die Industrie reagierte, indem sie eine Minderheit von Attention-Schichten beibehielt.
Beides sind Herstellerzahlen auf Hersteller-Stacks, und beides ist strukturell wenig überraschend: Man hat das entfernt, was wächst.
Zustandsraum · Mamba, RWKV, KDA
Rekurrenter Zustand fester Größe, linearer Rechenaufwand in der Sequenzlänge. Wird als Hybrid mit einem Verhältnis von etwa 3:1 ausgeliefert.
Diffusion · Mercury, LLaDA
Entrauscht viele Token auf einmal statt einen nach dem anderen. Beworben mit 5–10× schnellerer Inferenz.
Gemeinsames Embedding · JEPA
Sagt in einem latenten Raum voraus, statt Pixel oder Token zu erzeugen. LeCun verließ Meta und gründete 2026 AMI Labs.
Der unveränderte Standard
Der Transformer, weiterhin die Basis jedes oben genannten Modells – nur nicht mehr das Ganze.
Der Gegenfall ist wichtig. MiniMax setzte den Linear-Hybrid-Ansatz bei 456B um und machte öffentlich einen Rückzieher: Man lieferte Full Attention mit einem Postmortem aus – Parität im Entwicklungsmaßstab, Multi-Hop-Defizite in größerem Maßstab. Ein Paper von Juni 2026 stellte fest, dass Chain-of-Thought-Fine-Tuning den Long-Range-Recall in Hybriden verschlechtert. Recall ist keine Eigenschaft, die eine Architektur einmal besitzt; es ist eine Eigenschaft, die ein Checkpoint besitzt – nach allem, was man mit ihm gemacht hat.
Diffusion ist keine Kuriosität mehr
Diffusions-Sprachmodelle kehren den üblichen Vertrag um. Statt Token für Token auszugeben, starten sie mit Rauschen und entrauschen einen ganzen Block parallel, wobei sie iterieren, bis der Text sich herausbildet. Inceptions Mercury war die erste kommerzielle Version und wurde mit der fünf- bis zehnfachen Inferenzgeschwindigkeit vergleichbarer autoregressiver Modelle beworben; bis 2026 überschreitet die gehostete Generation tausend Token pro Sekunde, wobei LLaDA 2 mit 70B und Googles Gemini Diffusion zur selben Familie gehören.
Die Effizienzbehauptung bezieht sich auf Inferenz, nicht auf Training, und diese Unterscheidung geht verloren. Schnelleres Dekodieren verändert die Ökonomie des Servings und von Agent-Loops. Für sich genommen macht es ein Modell nicht schlauer pro Einheit Trainings-Compute.

Die Compute-Frage, die die eigentliche Frage ist
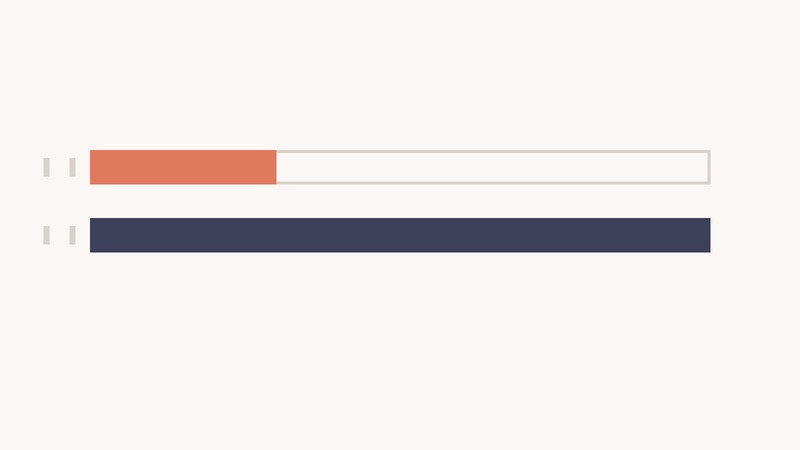
Hier wird das Argument konkret genug, um es zu testen. HRM-Text, ein 1B-Modell aus einer Gruppe, zu der auch Yasin Abbasi Yadkori gehört, ersetzt den Standard-Transformer durch ein hierarchisches rekurrentes Modell, das die Berechnung in eine langsame strategische Schicht und eine schnelle Ausführungsschicht aufteilt. Von Grund auf mit 40 Milliarden Tokens und einem Budget von 1.500 US-Dollar trainiert, meldet es 60,7 auf MMLU, 84,5 auf GSM8K und 56,2 auf MATH – konkurrenzfähig mit offenen Modellen, die zwei- bis siebenmal größer sind, bei ungefähr 96- bis 432-mal weniger geschätztem Rechenaufwand als die Standard-Baselines.
Lies das sorgfältig. Es ist ein 1B-Modell, kein Frontier-Modell, und „estimated“ leistet in dem Satz entscheidende Arbeit. Aber es ist ein Existenzbeweis für genau das, worauf es ankommt: eine andere Architektur plus ein anderes Trainingsziel ergaben ein radikal besseres Verhältnis von Leistungsfähigkeit zu Rechenaufwand.
Mal weniger Trainingsrechenleistung als Standard-Baselines
Mal weniger, gemäß der Obergrenze des Papers
Die Frontier-Scale-Version derselben Richtung ist leiser. Der Bericht zu Kimi K3 enthält einen Scaling-Fit, bei dem seine Attention-Variante bei etwa 1,16-mal weniger Rechenleistung denselben Loss erreicht – eine Einsparung von 14 Prozent, keine Revolution, und extrapoliert aus einer Forschungstestumgebung statt bei 2,8 Billionen Parametern gemessen. So sieht Fortschritt üblicherweise aus, bevor er wie ein Durchbruch aussieht.
Warum ein Durchbruch die vernünftige Wette ist
Das Argument ist nicht, dass irgendeine einzelne Architektur kurz davor steht zu gewinnen. Es ist, dass der Suchraum breiter geworden ist, während die Messung präziser wurde.
Ein Jahrzehnt lang gab es eine Architektur und ein Rezept, sodass Fähigkeit aus mehr Rechenleistung und mehr Daten kam. Jetzt gibt es vier Familien in Produktion oder ernsthafter Forschung, jede mit einem anderen Fehlermodus: Hybride verlieren den exakten Recall, Diffusion verliert den Links-nach-rechts-Vertrag, JEPA verliert die Schnittstelle des generierten Textes, der Transformer verliert das Speicherargument. Unterschiedliche Fehlermodi bedeuten unterschiedliche Nischen, und Nischen bedeuten parallele Finanzierung.
Nichts hier deutet darauf hin, dass der gesamte Rechenaufwand für das Training sinkt – die eigenen Pläne der Branche weisen in die entgegengesetzte Richtung. Die Behauptung, die sich lohnt, ist enger gefasst und nützlicher: Die Menge an Intelligenz, die pro Einheit Rechenleistung herauskommt, verbessert sich nicht mehr nur, weil die Modelle größer werden. Sie verbessert sich, weil sich die Form der Berechnung ändert – und diese Richtung ist kaum erforscht, verglichen damit, wie lange die Architektur selbst nicht mehr infrage gestellt wurde.
Nichts davon trägt ein Datum. Was sich heute überprüfen lässt: Hybride werden im Frontier-Maßstab ausgeliefert, Diffusion dekodiert mit tausend Tokens pro Sekunde, hinter der Latent-Prediction-Forschung steht ein Milliarden-Dollar-Labor, und ein 1B-Modell unterbietet den Standard-Trainingscompute um zwei Größenordnungen. Wenn sich die Achse mit dem Tempo der letzten achtzehn Monate weiterbewegt, ist die Frage nicht mehr, ob ein Durchbruch kommt, sondern welche Familie ihn liefert.
Quelle: arXiv 2605.20613 (HRM-Text); Kimi-K3-Technikbericht (Juli 2026); „State-Space-Modelle im Jahr 2026: Die Recall-Lücke“ (August 2026), unter Verweis auf arXiv 2507.06457, 2603.15569 und 2606.11052; Material von Inception Labs zu Mercury; State-Space- und JEPA-Literatur bis November 2026.
Kontakt: [email protected]
Bitte beachten Sie, dass die deutsche Version von Ai unterstützt wird und daher geringfügige Fehler auftreten können.
AUTOR
Über ABN Asia: Ai-Banking-NetworkSecurity (ABN), ABN Asia wurde im Jahr 2012 gegründet und ist ein Unternehmen mit akademischem Hintergrund, das von Lehrkräften und ehemaligen Studierenden aus Ungarn, den Niederlanden, Russland, Deutschland und Japan gegründet wurde. Wir teilen eine gemeinsame Leidenschaft und eine klare Vision für Technologie, die Innovation und erstklassige Qualität für unsere Kunden bringt. Unser Motto lautet: Besser. Schneller. Sicherer. In vielen Fällen: Günstiger.
Zögern Sie nicht, uns zu kontaktieren, wenn Sie IT-Dienstleistungen, digitale Beratung, Standardsoftwarelösungen benötigen oder uns Angebotsanfragen (RFPs) senden möchten. Sie können uns unter [email protected] kontaktieren. Wir sind bereit, Ihnen bei all Ihren Technologiebedürfnissen zu helfen.

© ABN ASIA