- เผยแพร่เมื่อ
Transformer กำลังกลายเป็นองค์ประกอบหนึ่ง
- ผู้เขียน

- ชื่อ
- AbnAsia.org
- @steven_n_t
Listen in English · Transformer กำลังกลายเป็นองค์ประกอบหนึ่ง
0:00 / 0:00
Watch in English · Transformer กำลังกลายเป็นองค์ประกอบหนึ่ง
เมื่อคุณใช้เวลากับผู้ที่สร้างโมเดลระดับแนวหน้า จะมีรูปแบบหนึ่งปรากฏขึ้นซึ่งลีดเดอร์บอร์ดซ่อนไว้: มีจำนวนมากผิดปกติของคนกลุ่มนี้ที่กำลังทำงานกับบางสิ่งที่ไม่ใช่ Transformer
ใช้เวลาคลุกคลีกับคนที่สร้างโมเดลล้ำสมัย แล้วคุณจะเห็นรูปแบบหนึ่งที่ตารางอันดับซ่อนไว้: พวกเขาจำนวนมากอย่างผิดปกติกำลังทำงานกับบางสิ่งที่ไม่ใช่ Transformer
ยังไม่แทนที่มันในไตรมาสนี้ กำลังทำเรื่องนี้เป็นโจทย์วิจัยที่มีชีวิต ควบคู่กันไป ด้วยเงินจริง สถาปัตยกรรมเชิงทำนายแบบ JEPA ที่ไม่เคยสร้างโทเคนหรือพิกเซลเลย โมเดลภาษาดิฟิวชันที่ดีนอยซ์ทั้งย่อหน้าในคราวเดียว Mamba และตระกูลสเตตสเปซ ซึ่งแทนที่การสแกนแบบกำลังสองของแอตเทนชันด้วยสถานะรีเคอร์เรนต์ขนาดคงที่ แต่ละแนวทางเป็นคำตอบที่แตกต่างกันสำหรับคำถามเดียวกัน: เครื่องจักรควรคำนวณอะไรกันแน่?
สิ่งที่ถูกส่งมอบจริง
ยังไม่มีใครปล่อยโมเดลรีเคอร์เรนต์ล้วนที่ใหญ่กว่าระดับกลางออกมา สิ่งที่ออกมาคืออัตราส่วน การศึกษาเปรียบเทียบแบบจับคู่ของแอตเทนชันเชิงเส้นแบบไฮบริดชี้ว่าช่วงที่ใช้งานได้คืออัตราส่วนเชิงเส้นต่อเต็ม 3:1 ถึง 6:1 โดยไฮบริดเข้าใกล้หรือเกิน baseline แอตเทนชันแบบเต็มใน benchmark ด้านการเรียกคืน ด้วย KV cache น้อยลงสี่ถึงเจ็ดเท่า รายงานของ Kimi K3 ระบุผล ablation ของตัวเองไว้ที่ 3:1 — validation perplexity 5.65 เทียบกับ 5.66 ที่ 1:1 — ครอบคลุมเลเยอร์ข้อความ 93 เลเยอร์ โดย 24 เลเยอร์เป็นแอตเทนชันแบบเต็ม Nemotron-H ของ NVIDIA รายงานว่า inference เร็วขึ้นถึงประมาณสามเท่าที่ความแม่นยำเท่ากัน ส่วน Granite 4.0-H ของ IBM รายงานว่าหน่วยความจำต่ำลงมากกว่า 70 เปอร์เซ็นต์
ข้อถกเถียงเรื่องสเตตสเปซดำเนินมาตั้งแต่ Mamba ในปี 2023 สรุปคะแนนตามจริงคือ การผสมแบบเวลาเชิงเส้นชนะด้านทรูพุตและหน่วยความจำ แต่สูญเสียความสามารถในการเรียกคืนเมื่อใช้เพียงลำพัง และอุตสาหกรรมตอบสนองด้วยการคงเลเยอร์ attention ไว้เพียงส่วนน้อย
ทั้งสองเป็นตัวเลขจากผู้ขายบนสแต็กของผู้ขาย และทั้งสองก็ไม่น่าแปลกใจในเชิงโครงสร้าง: คุณได้เอาสิ่งที่เติบโตออกไป
ปริภูมิสถานะ · Mamba, RWKV, KDA
สถานะเวียนซ้ำขนาดคงที่ คำนวณเชิงเส้นตามความยาวลำดับ ใช้งานจริงเป็นแบบไฮบริดในสัดส่วนประมาณ 3:1
ดิฟฟิวชัน · Mercury, LLaDA
ดีนอยซ์หลายโทเคนพร้อมกันแทนที่จะทำทีละโทเคน โฆษณาว่าการอนุมานเร็วขึ้น 5–10 เท่า
การฝังร่วม · JEPA
ทำนายในปริภูมิแฝงแทนการสร้างพิกเซลหรือโทเคน LeCun ออกจาก Meta และก่อตั้ง AMI Labs ในปี 2026
ค่าเริ่มต้นที่ไม่เปลี่ยนแปลง
Transformer ยังคงเป็นฐานของทุกโมเดลข้างต้น — เพียงแต่ไม่ใช่ทั้งหมดของมันอีกต่อไป
เคสโต้แย้งนี้สำคัญ MiniMax เดินกลยุทธ์ linear-hybrid ที่ 456B แล้วถอยกลับอย่างเปิดเผย โดยปล่อย full attention ออกมาพร้อมบทวิเคราะห์หลังเหตุการณ์: เทียบเท่ากันในสเกลพัฒนา แต่ขาดความสามารถ multi-hop เมื่อสเกลใหญ่ขึ้น งานวิจัยเดือนมิถุนายน 2026 พบว่าการ fine-tuning ด้วย chain-of-thought ทำให้ long-range recall ใน hybrid แย่ลง Recall ไม่ใช่คุณสมบัติที่สถาปัตยกรรมมีอยู่เพียงครั้งเดียว แต่เป็นคุณสมบัติที่ checkpoint มี หลังจากทุกอย่างที่คุณทำกับมัน
Diffusion ไม่ใช่แค่ของแปลกอีกต่อไป
โมเดลภาษาดิฟฟิวชันพลิกข้อตกลงปกติ แทนที่จะปล่อยโทเคนทีละตัว พวกมันเริ่มจากสัญญาณรบกวนแล้วลดสัญญาณรบกวนทั้งบล็อกพร้อมกัน ทำซ้ำจนข้อความก่อตัวสมบูรณ์ Mercury ของ Inception เป็นเวอร์ชันระดับพาณิชย์รุ่นแรก โดยโฆษณาว่าเร็วในการอนุมานเป็นห้าถึงสิบเท่าของโมเดลออโตรีเกรสซีฟที่เทียบเคียงได้ ภายในปี 2026 รุ่นที่ให้บริการแบบโฮสต์กำลังทำความเร็วเกินหนึ่งพันโทเคนต่อวินาที โดยมี LLaDA 2 ขนาด 70B และ Gemini Diffusion ของ Google อยู่ในตระกูลเดียวกัน
ข้อกล่าวอ้างเรื่องประสิทธิภาพนั้นเกี่ยวกับการอนุมาน ไม่ใช่การฝึก และความแตกต่างนี้มักถูกละเลย การถอดรหัสที่เร็วขึ้นเปลี่ยนเศรษฐศาสตร์ของการให้บริการและการทำงานแบบวนซ้ำของเอเจนต์ แต่ไม่ได้ทำให้โมเดลฉลาดขึ้นต่อหน่วยกำลังประมวลผลที่ใช้ฝึกด้วยตัวมันเอง

คำถามเรื่องกำลังประมวลผล ซึ่งเป็นคำถามที่แท้จริง
นี่คือจุดที่ข้อโต้แย้งชัดเจนพอจะทดสอบได้ HRM-Text โมเดลขนาด 1B จากกลุ่มที่รวม Yasin Abbasi Yadkori เข้ามาแทนที่ Transformer มาตรฐานด้วยโมเดลแบบเรียกซ้ำตามลำดับชั้นที่แบ่งการคำนวณออกเป็นชั้นกลยุทธ์ที่ช้าและชั้นปฏิบัติการที่เร็ว ฝึกตั้งแต่ต้นบน 40 พันล้านโทเค็นด้วยงบประมาณ $1,500 รายงานผล 60.7 บน MMLU, 84.5 บน GSM8K และ 56.2 บน MATH — เทียบได้กับโมเดลเปิดที่ใหญ่กว่า 2 ถึง 7 เท่า โดยใช้การคำนวณโดยประมาณน้อยกว่า 96 ถึง 432 เท่า เมื่อเทียบกับ baseline มาตรฐาน
อ่านสิ่งนั้นให้ดี มันเป็นโมเดลขนาด 1B ไม่ใช่โมเดลระดับแนวหน้า และคำว่า “estimated” กำลังทำหน้าที่สำคัญในประโยคนั้น แต่่มันเป็นข้อพิสูจน์การมีอยู่ของสิ่งเฉพาะเจาะจงที่สำคัญ: สถาปัตยกรรมที่แตกต่างออกไปบวกกับวัตถุประสงค์การฝึกที่แตกต่างออกไปก่อให้เกิดอัตราส่วนระหว่างความสามารถต่อพลังการประมวลผลที่ดีขึ้นอย่างมาก
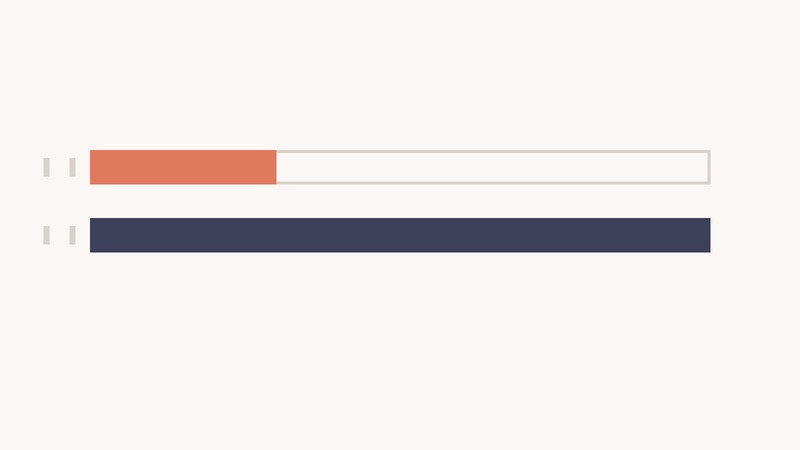
ใช้พลังประมวลผลในการฝึกน้อยกว่าฐานมาตรฐานหลายเท่า
น้อยกว่าหลายเท่า ตามขอบเขตบนของบทความ
เวอร์ชันระดับฟรอนเทียร์ของทิศทางเดียวกันนั้นเงียบกว่า รายงานของ Kimi K3 มีการฟิตสเกลลิงซึ่งตัวแปรแอตเทนชันของมันเข้าถึงค่า loss เท่ากันโดยใช้คอมพิวต์น้อยลงราว 1.16 เท่า — ประหยัดได้ 14 เปอร์เซ็นต์ ไม่ใช่การปฏิวัติ และเป็นการคาดการณ์ต่อยอดจากแท่นทดสอบวิจัย ไม่ใช่การวัดที่ 2.8 ล้านล้านพารามิเตอร์ ความก้าวหน้ามักมีหน้าตาแบบนี้ก่อนจะดูเหมือนความก้าวกระโดด
ทำไมความก้าวกระโดดจึงเป็นการเดิมพันที่สมเหตุสมผล
ข้อโต้แย้งไม่ใช่ว่าสถาปัตยกรรมใดสถาปัตยกรรมหนึ่งกำลังจะชนะ แต่คือพื้นที่การค้นหาได้กว้างขึ้น ขณะที่การวัดมีความแม่นยำขึ้น
เป็นเวลาหนึ่งทศวรรษที่มีสถาปัตยกรรมเดียวและสูตรเดียว ความสามารถจึงมาจากการประมวลผลที่มากขึ้นและข้อมูลที่มากขึ้น ตอนนี้มีสี่ตระกูลที่อยู่ในสายการผลิตหรือการวิจัยอย่างจริงจัง แต่ละตระกูลมีโหมดความล้มเหลวที่แตกต่างกัน: ไฮบริดสูญเสียการเรียกคืนแบบแม่นยำ ดิฟฟิวชันสูญเสียสัญญาการสร้างจากซ้ายไปขวา JEPA สูญเสียอินเทอร์เฟซของข้อความที่สร้างขึ้น Transformer สูญเสียข้อโต้แย้งเรื่องหน่วยความจำ โหมดความล้มเหลวที่แตกต่างกันหมายถึงช่องเฉพาะที่แตกต่างกัน และช่องเฉพาะหมายถึงการระดมทุนแบบคู่ขนาน
ไม่มีอะไรในนี้บ่งชี้ว่าพลังประมวลผลรวมที่ใช้ในการฝึกจะลดลง — แผนของอุตสาหกรรมเองชี้ไปในทางตรงกันข้าม ข้อกล่าวอ้างที่ควรกล่าวถึงนั้นแคบกว่าและมีประโยชน์กว่า: ปริมาณความฉลาดที่ได้กลับมาต่อหนึ่งหน่วยพลังประมวลผลไม่ได้ดีขึ้นเพียงเพราะโมเดลมีขนาดใหญ่ขึ้นอีกต่อไป มันดีขึ้นเพราะรูปแบบของการคำนวณกำลังเปลี่ยนไป — และทิศทางนั้นแทบจะยังไม่ได้รับการสำรวจเลย เมื่อเทียบกับระยะเวลาที่ยาวนานนับตั้งแต่ครั้งสุดท้ายที่มีใครตั้งคำถามกับสถาปัตยกรรมของมันเอง
ไม่มีข้อใดในนี้ระบุวันที่ สิ่งที่ตรวจสอบได้ ณ วันนี้คือ โมเดลไฮบริดถูกส่งมอบในระดับแนวหน้า ดิฟฟิวชันถอดรหัสได้พันโทเคนต่อวินาที งานวิจัยด้านการพยากรณ์ในปริภูมิแฝงมีห้องแล็บมูลค่าพันล้านดอลลาร์หนุนหลัง และโมเดลขนาด 1B ใช้พลังคำนวณในการฝึกต่ำกว่ามาตรฐานถึงสองอันดับขนาด หากแกนนี้ยังเคลื่อนที่ด้วยอัตราของสิบแปดเดือนที่ผ่านมา คำถามจะไม่ใช่ว่าความก้าวหน้าครั้งสำคัญจะมาหรือไม่ แต่จะเป็นตระกูลไหนที่ส่งมอบมัน
ที่มา: arXiv 2605.20613 (HRM-Text); รายงานทางเทคนิค Kimi K3 (กรกฎาคม 2026); “State Space Models in 2026: The Recall Gap” (สิงหาคม 2026) โดยอ้างอิง arXiv 2507.06457, 2603.15569 และ 2606.11052; เอกสาร Mercury ของ Inception Labs; วรรณกรรมด้าน state-space และ JEPA ถึงเดือนพฤศจิกายน 2026
ติดต่อ: [email protected]
โปรดทราบว่าเวอร์ชันภาษาไทยได้รับการช่วยเหลือจาก AI ดังนั้นอาจมีข้อผิดพลาดเล็กน้อย
ผู้เขียน
Ai-Banking-NetworkSecurity (ABN), ABN ASIA ถูกก่อตั้งขึ้นโดยคนที่มีรากฐานลึกในวงการวิชาการ มีประสบการณ์การทำงานในสหรัฐอเมริกา ดัตช์ ฮังการี ญี่ปุ่น เกาหลีใต้ สิงคโปร์ และเวียดนาม ABN Asia เป็นที่เราพบกันของวิทยาลัยและเทคโนโลยี ด้วยโซลูชันขั้นสูงและบริการพัฒนาซอฟต์แวร์ที่มีความสามารถ เราช่วยธุรกิจเติบโตและเข้าสู่ฉากโลก ความมุ่งมั่นของเรา: ด่วนขึ้น ดีขึ้น น่าเชื่อถือมากขึ้น ในกรณีส่วนมาก: ราคาถูกด้วย
หากคุณต้องการบริการ IT การให้คำปรึกษาดิจิทัล โซลูชันซอฟต์แวร์ใช้ได้หรือหากคุณต้องการส่งคำขอข้อเสนอ (RFPs) อย่าลังเลที่จะติดต่อเรา คุณสามารถติดต่อเราได้ที่ [email protected] เราพร้อมช่วยเหลือคุณด้านทุกความต้องกรทางเทคโนโลยีของคุณทุกเมื่อ

© ABN ASIA