- Xuất bản vào
Transformer đang trở thành một thành phần.
- Tác giả

- Tên
- AbnAsia.org
- @steven_n_t
Listen to this article · Transformer đang trở thành một thành phần.
0:00 / 0:00
Watch in English · Transformer đang trở thành một thành phần.
Hãy dành thời gian với những người đang xây dựng các mô hình tiên phong, bạn sẽ nhận ra một quy luật mà các bảng xếp hạng che giấu: một số lượng bất thường trong số họ đang làm việc trên một thứ không phải là Transformer.
Dành thời gian với những người đang xây dựng các mô hình tiên phong và một quy luật sẽ hiện ra mà các bảng xếp hạng che giấu: một số lượng bất thường trong số họ đang làm việc trên một thứ không phải là Transformer.
Không thay thế nó trong quý này. Đang xử lý nó như một câu hỏi nghiên cứu thời sự, song song, bằng tiền thật. Các kiến trúc dự đoán kiểu JEPA không bao giờ sinh ra một token hay một pixel. Các mô hình ngôn ngữ khuếch tán khử nhiễu cả một đoạn văn cùng lúc. Mamba và họ không gian trạng thái, thay phép quét bậc hai của attention bằng một trạng thái hồi quy kích thước cố định. Mỗi thứ là một câu trả lời khác nhau cho cùng một câu hỏi: máy thực sự nên tính toán gì?
Những gì thực sự đã được triển khai
Không ai phát hành một mô hình recurrent thuần túy ở quy mô trên trung bình. Thứ được triển khai là một tỷ lệ. Một nghiên cứu so khớp về attention tuyến tính lai đã đặt dải hữu ích ở mức 3:1 đến 6:1 tuyến tính trên đầy đủ, trong đó các mô hình lai tiến gần hoặc vượt đường cơ sở full-attention trên các benchmark truy hồi với KV cache ít hơn bốn đến bảy lần. Báo cáo của Kimi K3 đưa ablation của riêng nó về mức 3:1 — perplexity validation 5,65 so với 5,66 ở mức 1:1 — trên 93 lớp văn bản, 24 trong số đó là full attention. Nemotron-H của NVIDIA báo cáo suy luận nhanh hơn tới khoảng ba lần với độ chính xác tương đương; Granite 4.0-H của IBM báo cáo bộ nhớ thấp hơn hơn 70 phần trăm.
Lập luận không gian trạng thái đã diễn ra từ Mamba vào năm 2023. Bảng điểm trung thực: trộn thời gian tuyến tính thắng về thông lượng và bộ nhớ, tự nó thua về khả năng hồi tưởng, và ngành phản ứng bằng cách giữ lại một thiểu số lớp attention.
Cả hai đều là số liệu của nhà cung cấp trên các ngăn xếp của nhà cung cấp, và cả hai đều không đáng ngạc nhiên về mặt cấu trúc: bạn đã loại bỏ thứ vốn tăng trưởng.
Không gian trạng thái · Mamba, RWKV, KDA
Trạng thái hồi quy kích thước cố định, tính toán tuyến tính theo độ dài chuỗi. Được triển khai dưới dạng lai với tỷ lệ khoảng 3:1.
Khuếch tán · Mercury, LLaDA
Khử nhiễu nhiều token cùng lúc thay vì từng token một. Được quảng cáo có suy luận nhanh hơn 5–10 lần.
Nhúng chung · JEPA
Dự đoán trong không gian ẩn thay vì tạo pixel hoặc token. LeCun rời Meta và thành lập AMI Labs vào năm 2026.
Mặc định không thay đổi
Transformer, vẫn là nền tảng của mọi mô hình ở trên — chỉ không còn là toàn bộ của chúng nữa.
Trường hợp phản chứng rất quan trọng. MiniMax đã triển khai hướng tiếp cận lai tuyến tính ở quy mô 456B và đảo ngược công khai, tung ra full attention kèm phân tích hậu kiểm: ngang bằng ở quy mô phát triển, thiếu hụt khả năng đa bước ở quy mô lớn hơn. Một bài báo tháng 6/2026 phát hiện việc tinh chỉnh chuỗi suy luận làm suy giảm khả năng nhớ dài hạn ở các mô hình lai. Khả năng nhớ không phải là thuộc tính mà một kiến trúc có một lần; đó là thuộc tính của một checkpoint, sau tất cả những gì bạn đã làm với nó.
Diffusion không còn là thứ gây tò mò nữa
Các mô hình ngôn ngữ khuếch tán đảo ngược quy ước thông thường. Thay vì phát ra từng token một, chúng bắt đầu từ nhiễu và khử nhiễu cả một khối song song, lặp lại cho đến khi văn bản hiện rõ. Mercury của Inception là phiên bản quy mô thương mại đầu tiên, được quảng cáo có tốc độ suy luận nhanh gấp năm đến mười lần các mô hình tự hồi quy tương đương; đến năm 2026, thế hệ được triển khai dưới dạng dịch vụ đang vượt qua một nghìn token mỗi giây, với LLaDA 2 ở 70B và Gemini Diffusion của Google trong cùng nhóm.
Tuyên bố về hiệu quả là nói về suy luận, không phải huấn luyện, và sự phân biệt đó thường bị bỏ sót. Giải mã nhanh hơn thay đổi kinh tế của việc phục vụ và của các vòng lặp tác nhân. Bản thân nó không làm cho một mô hình thông minh hơn trên mỗi đơn vị tính toán huấn luyện.

Câu hỏi về tính toán, câu hỏi thực sự
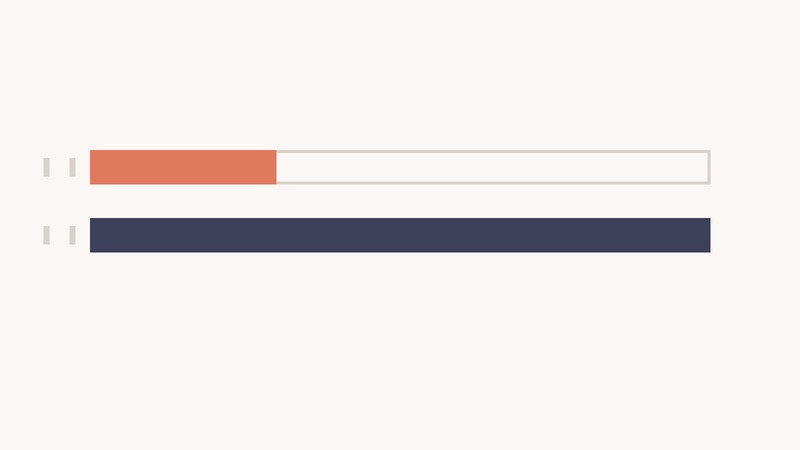
Đây là chỗ lập luận trở nên cụ thể đủ để kiểm chứng. HRM-Text, một mô hình 1B từ một nhóm bao gồm Yasin Abbasi Yadkori, thay thế Transformer tiêu chuẩn bằng một mô hình hồi quy phân cấp chia tính toán thành một tầng chiến lược chậm và một tầng thực thi nhanh. Được huấn luyện từ đầu trên 40 tỷ token với ngân sách 1.500 USD, mô hình báo cáo 60,7 trên MMLU, 84,5 trên GSM8K và 56,2 trên MATH — cạnh tranh với các mô hình mở lớn hơn từ hai đến bảy lần, với lượng tính toán ước tính ít hơn khoảng 96 đến 432 lần so với các đường cơ sở tiêu chuẩn.
Hãy đọc kỹ điều đó. Đây là một mô hình 1B, không phải mô hình tiên phong, và từ “ước tính” đang gánh vai trò quan trọng trong câu. Nhưng nó là một bằng chứng tồn tại cho đúng điều cụ thể quan trọng: một kiến trúc khác cộng với một mục tiêu huấn luyện khác đã tạo ra tỷ lệ năng lực trên chi phí tính toán tốt hơn rất nhiều.
lần ít tài nguyên tính toán huấn luyện hơn so với các baseline chuẩn
lần ít hơn, theo cận trên trong bài báo
Phiên bản ở quy mô tiên phong của cùng hướng đi này kín đáo hơn. Báo cáo của Kimi K3 bao gồm một phép khớp scaling, trong đó biến thể attention của nó đạt mức loss tương đương với lượng tính toán ít hơn khoảng 1,16 lần — tiết kiệm 14%, không phải một cuộc cách mạng, và được ngoại suy từ một testbed nghiên cứu thay vì được đo ở 2,8 nghìn tỷ tham số. Tiến bộ thường trông như vậy trước khi trông giống một bước đột phá.
Vì sao một bước đột phá là đặt cược hợp lý
Luận điểm không phải là bất kỳ kiến trúc đơn lẻ nào sắp giành chiến thắng. Mà là không gian tìm kiếm đã mở rộng trong khi phép đo trở nên sắc bén hơn.
Trong một thập kỷ, chỉ có một kiến trúc và một công thức, nên năng lực đến từ nhiều tính toán và nhiều dữ liệu hơn. Giờ đây có bốn họ mô hình đang trong sản xuất hoặc nghiên cứu nghiêm túc, mỗi họ có một kiểu thất bại khác nhau: mô hình lai mất khả năng truy hồi chính xác, diffusion mất quy ước từ trái sang phải, JEPA mất giao diện của văn bản được tạo sinh, Transformer mất lập luận về bộ nhớ. Các kiểu thất bại khác nhau nghĩa là các ngách khác nhau, và các ngách nghĩa là tài trợ song song.
Không có gì ở đây cho thấy tổng năng lực tính toán dùng để huấn luyện giảm — kế hoạch của chính ngành lại chỉ ra điều ngược lại. Tuyên bố đáng đưa ra thì hẹp hơn và hữu ích hơn: lượng trí tuệ thu được trên mỗi đơn vị tính toán không còn chỉ cải thiện vì các mô hình lớn hơn. Nó đang cải thiện vì hình dạng của phép tính đang thay đổi — và hướng đi đó hầu như chưa được khai phá so với quãng thời gian đã trôi qua kể từ khi có ai đó đặt câu hỏi về chính kiến trúc.
Không điều nào trong số này có mốc thời gian. Điều có thể kiểm chứng hôm nay: các mô hình hybrid được triển khai ở quy mô tiên phong, diffusion giải mã với tốc độ một nghìn token mỗi giây, nghiên cứu dự đoán tiềm ẩn có một phòng thí nghiệm trị giá hàng tỷ đô đứng sau, và một mô hình 1B dùng ít hơn mức tính toán huấn luyện tiêu chuẩn hai bậc độ lớn. Nếu trục này tiếp tục dịch chuyển với tốc độ của mười tám tháng qua, câu hỏi sẽ không còn là liệu một đột phá có đến hay không, mà là dòng mô hình nào sẽ mang nó đến.
Nguồn: arXiv 2605.20613 (HRM-Text); báo cáo kỹ thuật Kimi K3 (tháng 7 năm 2026); “Mô hình không gian trạng thái năm 2026: Khoảng cách truy hồi” (tháng 8 năm 2026), trích dẫn arXiv 2507.06457, 2603.15569 và 2606.11052; tài liệu Mercury của Inception Labs; tài liệu về mô hình không gian trạng thái và JEPA đến tháng 11 năm 2026.
Liên hệ: [email protected]
TÁC GIẢ
Về ABN Asia: Ai-Banking-NetworkSecurity (ABN), ABN Asia được thành lập từ năm 2012, là một công ty xuất phát từ học thuật, do những giảng viên, cựu du học sinh Hungary, Hà Lan, Nga, Đức, và Nhật Bản sáng lập. Chúng tôi chia sẻ đam mê chung và tầm nhìn vững chắc về công nghệ, mang đến sự đổi mới và chất lượng đỉnh cao cho khách hàng. Phương châm của chúng tôi là: Tốt hơn. Nhanh hơn. An toàn hơn. Trong nhiều trường hợp: Rẻ hơn.
Hãy liên hệ với chúng tôi khi Quý doanh nghiệp có các nhu cầu về dịch vụ công nghệ thông tin, tư vấn chuyển đổi số, tìm kiếm các giải pháp phần mềm phù hợp, hoặc nếu Quý doanh nghiệp có đấu thầu CNTT (RFP) để chúng tôi tham dự. Quý doanh nghiệp có thể liên hệ với chúng tôi qua địa chỉ email [email protected]. Chúng tôi sẵn lòng hỗ trợ với mọi nhu cầu công nghệ của Quý doanh nghiệp.

© ABN ASIA